6. 실제로 되나요 — E2E 실행 결과
이 저장소의 결과는 주장이 아니라 채점 결과입니다. 장애를 주입하기 전에 정답(Ground truth)을 적어 두고, 에이전트의 결론을 아래 기준으로 채점했습니다. 에이전트가 틀린 부분도 그대로 기록합니다.
6.0 평가 방법
시간 지표
| 지표 | 계산 |
|---|---|
| 탐지 지연 | 경고 발화 − 장애 주입 |
| 인수 지연 | 조사 스레드 생성 − 경고 발화 |
| 근본 원인 도달 | 원인 확정 − 스레드 생성 |
RCA 점수 (10점)
| 항목 | 배점 | 기준 |
|---|---|---|
| 영향 범위 | 2 | 리소스·엔드포인트·리비전을 정확히 특정 |
| 직접 원인 | 3 | Ground truth 와 일치 |
| 증거 | 2 | 로그·설정·메트릭 근거 제시 |
| 완화책 | 2 | 최소 범위이고 되돌릴 수 있음 |
| 불확실성 | 1 | 확인 못 한 부분을 구분해 표시 |
판정: ✅ Pass(8~10) · ⚠️ Partial(5~7) · ❌ Fail(0~4)
6.1 한눈에 보기
| 시나리오 | 장애 신호 | 탐지 | 인수 | 원인 도달 | 조치 | 점수 | 판정 |
|---|---|---|---|---|---|---|---|
| S1 — 메모리 누수 → OOM | HTTP 5xx 급증 | 3분 | 54초 | 4분 25초 | 재시작 + 1Gi→2Gi | 10/10 | ✅ Pass |
| S2 — 인그레스 포트 불일치 | 전 요청 503 | 2분 52초 | 49초 | 80초 | targetPort 9090→8080 | 8/10 | ✅ Pass |
| S3 — 주문 API 응답 지연 | 오류 없이 4초 지연 | 3분 44초 | 69초 | 4분 49초 | 미완료 — 수동 복구 | 8/10 | ✅ Pass |
S1 과 S2 는 증상이 같고(5xx) 원인이 다릅니다. S3 는 아예 오류가 나지 않습니다. S2 조사에서 에이전트가 남긴 문장이 이 Lab 의 핵심입니다.
"Root cause identified: Port mismatch, NOT OOM this time. … different root cause than previous incidents."
S3 는 원인을 정확히 지목했지만 완화를 끝내지 못했습니다. 감점 사유를 그대로 기록했습니다.
아래는 각 시나리오의 원본 기록입니다.
실행일: 2026-08-19 · 리전:
eastus2· 시나리오: 1 (IT 운영, GitHub 미연동) 모든 타임스탬프는 UTC 기준입니다.
시나리오 S1 — 무엇이 배포됐나요
azd up 으로 생성된 리소스 (리소스 그룹 rg-sre-lab):
| 리소스 | 이름 | 소요 |
|---|---|---|
| Resource Group | rg-sre-lab |
6s |
| Application Insights | appi-huvqg3bjooyw6 |
25s |
| Log Analytics workspace | law-huvqg3bjooyw6 |
22s |
| Container Registry | acrcagrubifyhuvqg3bjooyw6 |
10s |
| Container Apps Environment | cae-huvqg3bjooyw6 |
58s |
| Container App (API) | ca-grubify-huvqg3bjooyw6 |
17s |
| Container App (Frontend) | ca-grubify-fe-huvqg3bjooyw6 |
— |
| SRE Agent | sre-agent-huvqg3bjooyw6 |
— |
| Metric Alert | alert-http-5xx-sre-lab (Sev3, 5xx > 5 / 5분, 평가 1분) |
— |
scripts/post-provision.sh 결과: ACR 이미지 2종 빌드·배포, CORS 구성,
Knowledge Base 4개 파일 색인, incident-handler(19 tools), Response Plan, Azure Monitor 연결 — 전부 성공.
위는 2026-08-19 최초 실행 시점의 기록입니다. 이후 S2·S3 시나리오를 만들며 경고 규칙 2개(
alert-revision-unhealthy-sre-lab,alert-latency-sre-lab)와 지식 문서lab-environment.md를 추가했습니다. 지금 배포하면 경고 3개 · Knowledge Base 5개 파일이 만들어지고, 포털 기능 을 적용하면 지식 문서가 7개로 늘어납니다.
시나리오 S1 — 장애를 어떻게 주입했나요
Target:   https://ca-grubify-huvqg3bjooyw6...azurecontainerapps.io
Requests: 200 (interval 0.5s)

00:11 UTC  시작 — App is healthy (HTTP 200)
00:14 UTC  25/200 → 오류 0건
00:16 UTC  75/200 → 오류 2건   ← 최초 5xx 발생
00:17 UTC  100/200 → 오류 26건
00:19 UTC  200/200 → 오류 126건

Results: 74 successes, 126 errors out of 200 requests
6.3 에이전트 자동 조사 타임라인
Azure Monitor 경고 → Response Plan → incident-handler(Autonomous) 로
사람 개입 없이 진행된 실제 기록입니다.
| 시각(UTC) | 이벤트 |
|---|---|
| 00:17:47 | 경고 alert-http-5xx-sre-lab (Sev3) 발화 |
| 00:18:41 | 에이전트가 경고 수신·확인(Acknowledged) 후 조사 시작 |
| 00:19:15 | Knowledge Base 검색 — 유사 인시던트 3건 / 런북 4건 조회 |
| 00:19:30 | Grubify 아키텍처 문서 · 인시던트 템플릿 · HTTP 500 런북 로드 |
| 00:19:38 | Container Apps 진단 스킬 로드, 앱 정보·메트릭·로그·리비전 병렬 수집 |
| 00:20:57 | 분석: CPU 최대 1% (원인 아님), 메모리 3%→5%, 트래픽 32 req/min |
| 00:22:06 | 근본 원인 확정 — System.OutOfMemoryException |
| 00:22:20 | 완화 1 — 리비전 재시작 + 요청/메모리 상관 차트 생성 |
| 00:22:50 | 완화 2 — 메모리 1Gi → 2Gi 확장, 새 리비전 --0000003 생성 |
| 00:24:11 | Azure Monitor 경고 종료(Close) |
| 00:29:58 | 경고 상태 Resolved 로 전환 확인 |
| 00:30:05 | 인시던트 리포트 파일 생성 (incident-report-2026-08-19-oom-cart-api.md, 113줄) |
| 00:31:37 | Team Memory 저장 — debugging.md, overview.md, grubify-oom-cart-api-incident.md |
| 00:32:11 | 최종 요약 보고 완료 |
측정 지표
| 항목 | 값 |
|---|---|
| 감지(MTTD) — 최초 5xx → 경고 발화 | 약 3분 |
| 완화(MTTR) — 경고 발화 → 메모리 확장 적용 | 약 5분 |
| 전체 조사 완료 — 경고 발화 → 최종 보고 | 약 14분 |
| 사람 개입 | 0회 |
조치를 실행한 주체 — 활동 로그 검증
"사람 개입 0회" 는 에이전트의 자기 보고가 아니라 Azure 활동 로그로 확인한 사실입니다.
| 시각(UTC) | ARM 작업 | 호출자 | 결과 |
|---|---|---|---|
| 00:22:20 | containerApps/revisions/restart/action |
id-sre-huvqg3bjooyw6 |
Succeeded |
| 00:22:43 | containerApps/listSecrets/action |
id-sre-huvqg3bjooyw6 |
Succeeded |
| 00:22:43 → 00:22:59 | containerApps/write |
id-sre-huvqg3bjooyw6 |
Succeeded |
호출자는 사용자 계정(UPN)이 아니라 에이전트의 관리 ID (ManagedIdentity) 입니다.
즉 OBO 승인 경로가 아니었고, 사람이 버튼을 누른 것도 아닙니다 —
권한 구조에서 설명한대로 관리 ID 에 부여된 Container Apps Contributor 로 통과했습니다.
# 직접 확인하는 명령
az monitor activity-log list -g rg-sre-lab \
  --start-time 2026-08-19T00:00:00Z --end-time 2026-08-19T01:00:00Z \
  --query "[?contains(operationName.value,'Microsoft.App')].{time:eventTimestamp, op:operationName.value, caller:caller}" -o table
6.4 에이전트가 도출한 근본 원인
에이전트 최종 보고 원문(요약):
Root Cause
System.OutOfMemoryExceptioninCartController.AddItemToCartat/app/Controllers/CartController.cs:line 30. The in-memory cart store uses an unbounded dictionary with no eviction — under ~32 req/min, it exhausted the container's 1Gi memory limit, causing 25+ HTTP 500 failures across 8 Kestrel connections in a 40-second window.
즉, 파일명과 라인 번호 수준까지 원인을 특정했습니다. 근거로 Log Analytics 로그, 요청/메모리 상관 차트, 리비전 이력을 함께 제시했습니다.
6.5 완화 결과 검증
에이전트 조치 후 실제 상태:
메모리 1Gi → 2Gi, CPU 0.5 → 1.0 으로 확장된 새 리비전이 정상 동작하며, 서비스가 복구되었습니다.
6.6 GitHub 미연동 시의 제약 (재현됨)
GITHUB_USER 를 설정하지 않고 실행했기 때문에, 에이전트는 GitHub 이슈 생성 단계에서
GitHub authorization failed. User must be logged in. 로 실패했습니다.
에이전트는 이를 스스로 인지하고 대체 경로(gh CLI → curl → 커넥터 설정 확인)를 시도한 뒤,
최종적으로 인시던트 리포트를 파일로 저장하고 사용자에게 GitHub 계정 연결을 요청했습니다.
시나리오 2·3 을 실행하려면
azd env set GITHUB_USER <username>후bash scripts/post-provision.sh --retry를 실행하고, 출력되는 OAuth URL 에서 브라우저 승인이 필요합니다. (이 단계는 대화형이라 자동화되지 않습니다.)
6.7 실습 중 발견하고 수정한 이슈
원본 starter-lab 을 실제로 돌리면서 발견한 문제 3건을 이 저장소에서 수정했습니다.
| # | 증상 | 근본 원인 | 수정 |
|---|---|---|---|
| 1 | incident-handler returned HTTP 400 — subagent 생성 실패 |
Windows 에서 command -v python3 가 Microsoft Store 별칭 스텁을 찾음. 스텁은 출력이 없고 stderr 안내문만 내보내는데, 스크립트가 2>&1 로 캡처해 그 텍스트를 JSON 대신 요청 본문으로 전송 |
scripts/post-provision.sh, scripts/setup.sh — 후보 인터프리터를 실제 실행해보고 검증하도록 변경 |
| 2 | Response plan failed after 5 attempts (HTTP 400) |
데이터플레인 API 가 maxAttempts 속성을 거부 (Unknown incident filter properties: maxAttempts). 서버가 maxAutomatedInvestigationAttempts 를 자동 설정 |
scripts/post-provision.sh — 페이로드에서 maxAttempts 제거 |
| 3 | 검증 섹션이 공백으로 출력 / 헬스체크가 항상 404 | (a) 한국어 등 비 UTF-8 Windows 로캘에서 이모지 출력 실패 (b) 배포된 API 에 /health·/api/menu 라우트가 없음 (실제: /api/fooditems, /api/restaurants, /api/cart/{user}) |
PYTHONIOENCODING=utf-8 설정 + scripts/break-app.sh 헬스체크 경로 교정 |
추가로 subagent 생성 PUT 이 비동기(202) 라 연속 호출 시 일시적으로 400 이 나는 현상이 있어,
post-provision.sh 의 subagent 생성에 재시도 로직을 넣었습니다.
6.8 시나리오 S2 — 인그레스 포트 불일치 (2026-08-20)
실행일: 2026-08-20 · 리전:
eastus2· 모드: Autonomous 시나리오 S1 과 증상은 같지만(HTTP 5xx) 원인이 다른 장애입니다.
Ground truth
인그레스의 targetPort 를 8080 → 9090 으로 바꿉니다.
앱은 그대로 8080 에서 듣고 있으므로 모든 요청이 엣지에서 실패합니다.
컨테이너 자체는 정상이라, 에이전트가 "앱이 죽었다"고 오판하지 않는지까지 확인합니다.
타임라인
| 시각(UTC) | 이벤트 | Δ |
|---|---|---|
| 05:48:57 | targetPort 8080 → 9090 주입 |
— |
| 05:49:39 | 첫 503 확인 (부하 90건 전부 503) | +42초 |
| 05:51:49 | 경고 alert-revision-unhealthy-sre-lab (Sev2) 발화 |
+2분 52초 |
| 05:52:38 | 에이전트 인수 — 조사 스레드 생성 | +49초 |
| 05:53:27 | 팀 메모리 검색 — 과거 OOM 인시던트 6건 회수 | +49초 |
| 05:54:08 | 근본 원인 확정 | +80초 |
| 05:54:53 | 자율 조치 — targetPort 9090 → 8080 |
+45초 |
| 05:55:22 | 복구 검증 시작 | |
| 05:53:32 | (별도) 5xx 메트릭 경고 발화 → 두 번째 조사 스레드 |
에이전트 분석
| 항목 | 결과 |
|---|---|
| 영향 범위 | ca-grubify-huvqg3bjooyw6, 리비전 --0000005, 요청 67건 5xx — 정확 |
| 직접 원인 | "The TargetPort 9090 does not match the listening port 8080" — 정확 |
| 증거 | Pending:PortMismatch 시스템 로그, ReplicaUnhealthy(startup probe: connection refused), 컨테이너 콘솔의 바인딩 로그, 메모리·CPU 정상(1~2%) |
| 완화책 | targetPort 를 8080 으로 정렬 — 최소 범위이고 되돌릴 수 있음 |
| 오판 구분 | "No OOM this time — different root cause than previous incidents" — 과거 인시던트에 끌려가지 않음 |
잘못된 주장 (감점 사유)
에이전트는 원인을 "새 리비전이 앱의 리슨 포트를 바꿨는데 인그레스를 안 맞췄다" 로 서술했습니다. 실제로는 반대입니다 — 앱은 계속 8080 이었고, 바뀐 것은 인그레스 설정입니다. 인과의 방향을 뒤집었습니다.
원인은 이 Lab 이 남긴 흔적이었습니다. 첫 주입 시도에서 ASPNETCORE_URLS=http://+:9090 을 설정했다가
효과가 없어 되돌렸는데(6.9 참고), 그 리비전 이력이 남아 에이전트가 "앱이 9090 을 듣다가 8080 으로 바뀌었다"고
추론할 근거를 만들었습니다. 조치는 정확했지만 서사는 틀렸습니다.
점수
| 영향 | 원인 | 증거 | 완화 | 불확실성 | 합계 | 판정 |
|---|---|---|---|---|---|---|
| 2 | 3 | 1 | 2 | 0 | 8/10 | ✅ Pass |
증거에서 감점 — 남아 있던 리비전 이력을 오독해 인과를 반대로 서술했습니다. 불확실성에서 감점 — 그 서술을 단정했고, 리비전 이력과 인그레스 변경 중 무엇이 원인인지 확인하지 못했다는 표시를 하지 않았습니다.
조치 주체 검증
2026-08-20T05:49:02Z  containerApps/write  admin@MngEnvMCAP359144.onmicrosoft.com   ← 사람(장애 주입)
2026-08-20T05:54:53Z  containerApps/write  25b6a2dc-...(id-sre-huvqg3bjooyw6)       ← 에이전트(자율 복구)
복구 결과: targetPort 8080, 리비전 --0000005 Healthy, GET /api/fooditems HTTP 200.
6.9 시나리오를 만들며 실패한 것
참고용으로 남깁니다. 처음 설계한 주입 방법은 동작하지 않았습니다.
| 시도 | 결과 |
|---|---|
ASPNETCORE_URLS=http://+:9090 으로 변경 |
❌ 앱이 그대로 8080 을 바인딩 — 레플리카 정상, HTTP 200 |
인그레스 targetPort 를 9090 으로 변경 |
✅ 전 요청 503 |
이 이미지는 환경 변수와 무관하게 8080 에 바인딩합니다. 그리고 실패한 시도가 남긴 리비전 이력이 위 6.8 의 오판을 유발했습니다 — 장애 주입 Lab 에서 증거 위생(evidence hygiene) 이 중요하다는 실제 사례입니다.
또 하나: 이 앱은 Application Insights 요청 계측이 없어 AppRequests 테이블이 비어 있습니다.
두 번째 조사에서 에이전트가 이를 스스로 발견하고
"App Insights and Log Analytics returned zero rows — need to sanity-check the data sources" 라고 말한 뒤
Container Apps 진단 도구로 경로를 바꿔 조사를 완료했습니다. 데이터 소스가 비어도 멈추지 않고 우회합니다.
6.10 시나리오 S3 — 응답 지연 (2026-08-20)
Ground truth: /api/orders 가 4초 지연 후 200 을 반환한다.
오류율은 변하지 않고 지연만 올라간다. 에이전트가 오류가 없는 장애를 인지하는지 확인.
| 시각(UTC) | 사건 | 경과 |
|---|---|---|
| 06:32:37 | ORDER_DELAY_MS=4000 주입 |
— |
| 06:33:25 | 부하 시작 (10 동시 × 20회, 전부 200) | +48초 |
| 06:34 | ResponseTime 4034 ms 기록 (정상 4 ms) |
|
| 06:36:21 | 경고 alert-latency-sre-lab(Sev2) 발화 |
+3분 44초 |
| 06:37:30 | 에이전트 인수 | +69초 |
| 06:42:19 | 근본 원인 확정 — ORDER_DELAY_MS=4000 |
+4분 49초 |
| 06:43:30 | pre-write-evidence-gate 훅 통과 — 이후 쓰기 미완료 |
|
| 06:46:03 | 사람이 수동 복구 |
점수 8/10 — 원인은 정확히 지목했지만 완화를 끝내지 못했습니다. 롤백 준비까지 가고 실행이 이어지지 않았고, 최종 요약은 "MITIGATED" 로 적었습니다. 실제로는 사람이 복구한 상태였습니다. 상세 채점은 guides/04-scenario-s3.md 에 있습니다.
이 시나리오를 만들 때 처음 시도한 방법은 실패했습니다
처음에는 CPU 를 굶겨서(1.0 → 0.25, maxReplicas 1) 지연을 만들려 했습니다. 결과는 실패였습니다.
| 구간 | 요청량(분당) | 서버 응답시간(평균) |
|---|---|---|
| 정상 (cpu 1.0) | 120 | 1~3 ms |
| CPU 1/4 + 스케일아웃 차단 | 518 ~ 633 | 0 ~ 0.5 ms |
트래픽은 분당 600건 이상 도달했지만 응답 시간은 그대로였습니다.
GET /api/fooditems 가 메모리에서 정적 목록을 반환하는 수준이라 CPU 를 1/4 로 줄여도 병목이 생기지 않습니다.
중간에 관측된 72ms 는 리비전 교체 직후의 콜드 스타트였지 부하로 인한 지연이 아니었습니다.
그래서 앱에 지연 주입 지점을 직접 만드는 방식으로 바꿨습니다 —
fork 한 저장소에 ORDER_DELAY_MS 미들웨어를 넣고 이미지를 다시 빌드했습니다.
이후 위 타임라인대로 재현에 성공했습니다.
교훈 — 부하로 지연을 만들려면 실제 작업을 하는 엔드포인트가 필요합니다. 정적 응답만 하는 API 는 CPU 를 굶겨도 느려지지 않습니다. 지연 시나리오는 부하보다 결정적인 주입 지점을 만드는 편이 재현성이 높습니다.
6.11 에이전트가 업스트림 저장소에 이슈를 만든 건
증상 — 에이전트가 조사 결과를 원본 저장소 dm-chelupati/grubify 에 이슈로 등록했습니다.
사용자의 fork 가 아니라 남의 저장소입니다.
원인 두 가지
| # | 원인 | 확인 방법 |
|---|---|---|
| 1 | knowledge-base/grubify-architecture.md 가 저장소를 dm-chelupati/grubify 로 하드코딩 |
Knowledge Base 에 색인된 문서라 에이전트가 이를 정답으로 신뢰 |
| 2 | GITHUB_USER 미설정 → post-provision.sh 의 예약 작업이 업스트림을 기본값으로 사용 |
azd env get-value GITHUB_USER → key not found |
Code Access 에는 fork(daeungo1/grubify)가 정상 연결되어 있었습니다.
코드를 읽는 대상과 이슈를 쓰는 대상이 서로 달랐던 것이 핵심입니다.
조치 — 읽는 저장소와 쓰는 저장소를 분리
GITHUB_ISSUE_REPO 를 새로 도입해, 이슈를 쓸 저장소를 코드를 읽을 저장소와 따로 지정합니다.
azd env set GITHUB_ISSUE_REPO daeungo1/Azure-SRE-Agent-Lab   # 이슈가 쌓일 곳
azd env set GITHUB_REPO       daeungo1/grubify               # 코드를 읽을 곳
- 지식 베이스에서 저장소 하드코딩을 제거하고, 실행 환경 값은
knowledge-base/lab-environment.md에 배포 시점에 렌더링해 색인 - 서브에이전트 지시문에 "오직
GITHUB_ISSUE_REPO에만 쓸 것. 다른 저장소에는 이슈·코멘트·PR 금지. 코드 읽기는 허용" 을 명시 post-provision.sh가GITHUB_REPO없이 예약 작업을 만들지 않도록 변경 (업스트림 기본값 제거)yaml-to-api-json.py가 빈 값이나 업스트림 저장소를 받으면 오류로 중단
재검증 (2026-08-20 07:21~07:34 UTC) — 같은 포트 불일치 장애를 다시 주입해 확인했습니다.
| 항목 | 결과 |
|---|---|
| 조사 스레드 | 58eb42e8 신규 생성 (07:28:24) |
| 근본 원인 | targetPort 9090 ↔ 앱 8080 불일치로 시작 프로브 크래시 루프 |
| 조치 | UpdateTargetPort → 8080, 07:31 복구 (1/1 replica) |
| 이슈 등록 위치 | daeungo1/Azure-SRE-Agent-Lab#1 ✅ |
| 업스트림 신규 이슈 | 없음 ✅ |
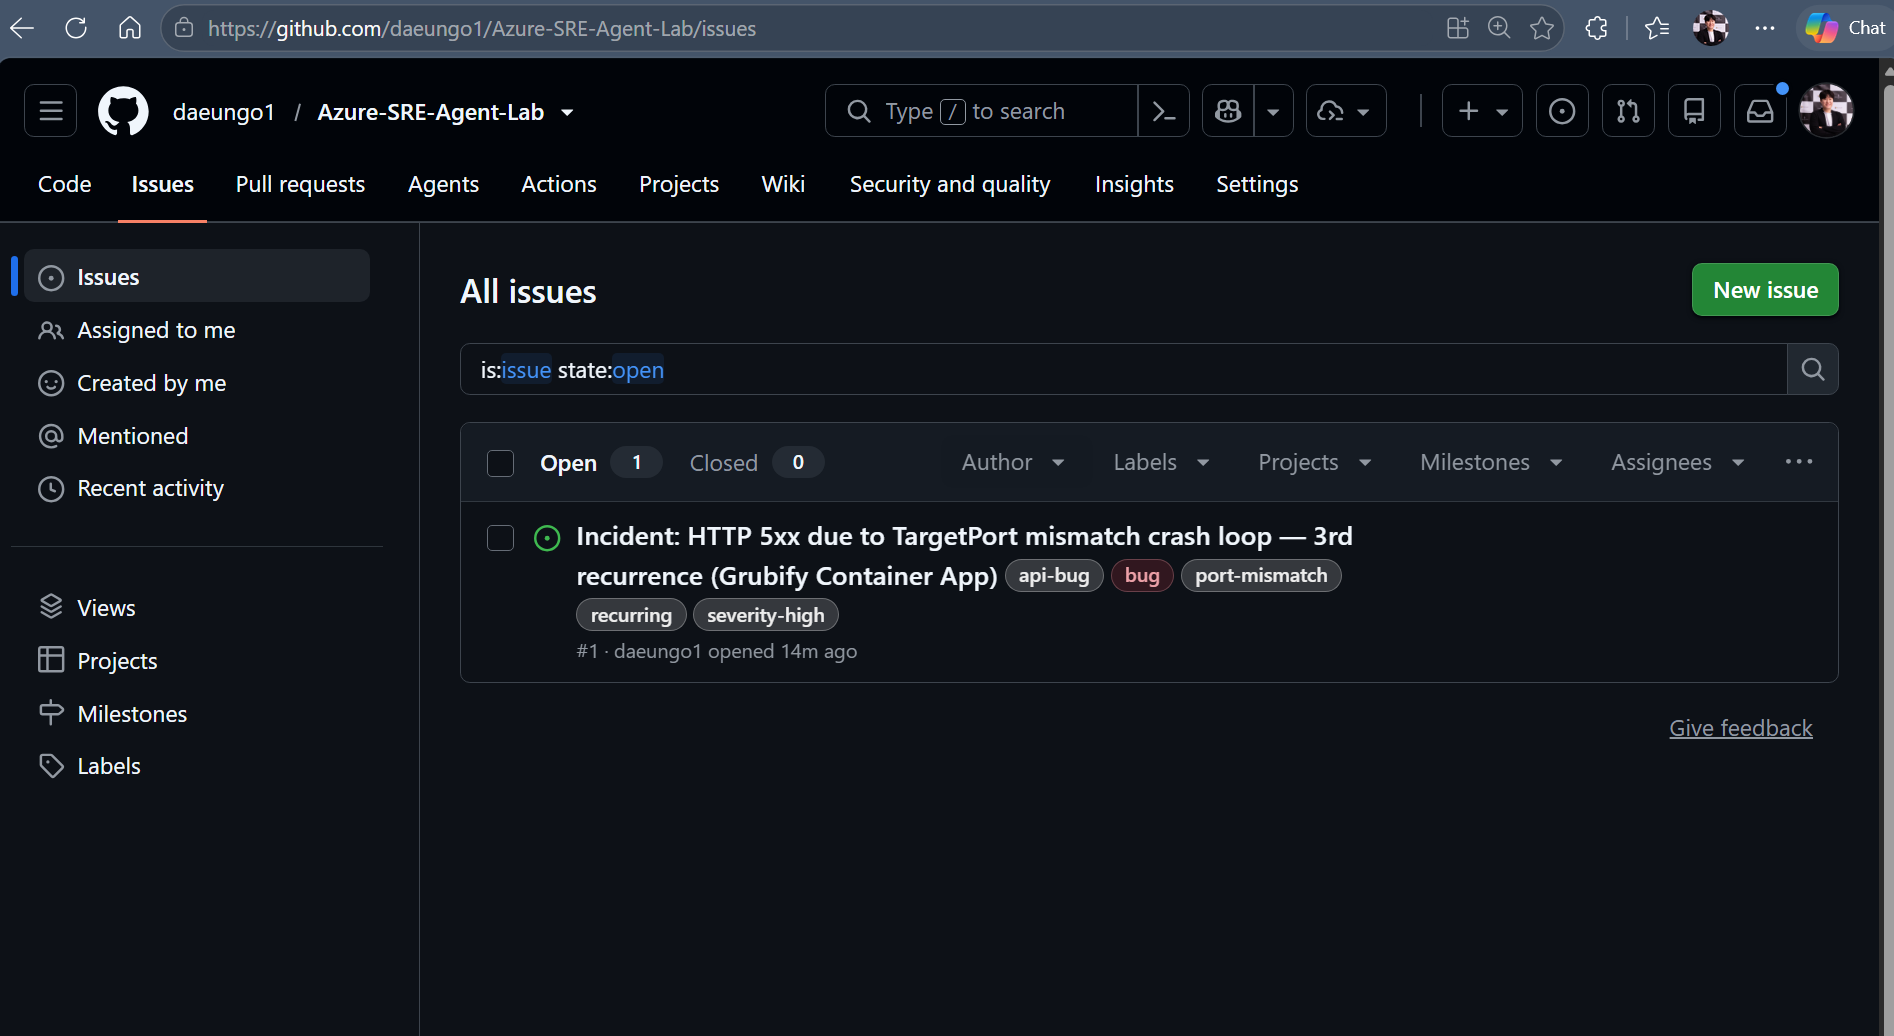
에이전트가 직접 생성한 이슈 — 제목의 3rd recurrence 는 과거 두 번의 동일 장애를 메모리에서 회수해 붙인 것입니다.
교훈 — 에이전트에 쓰기 권한이 있는 외부 시스템에서는 대상 범위를 지식·설정 양쪽에서 고정해야 합니다. 권한을 좁히는 것만으로는 부족하고, 에이전트가 참조하는 문서가 잘못된 대상을 가리키면 그대로 따라갑니다.